
FlashAttention 全版本演进:v1 → v4,从 IO 感知到算法-硬件协同设计
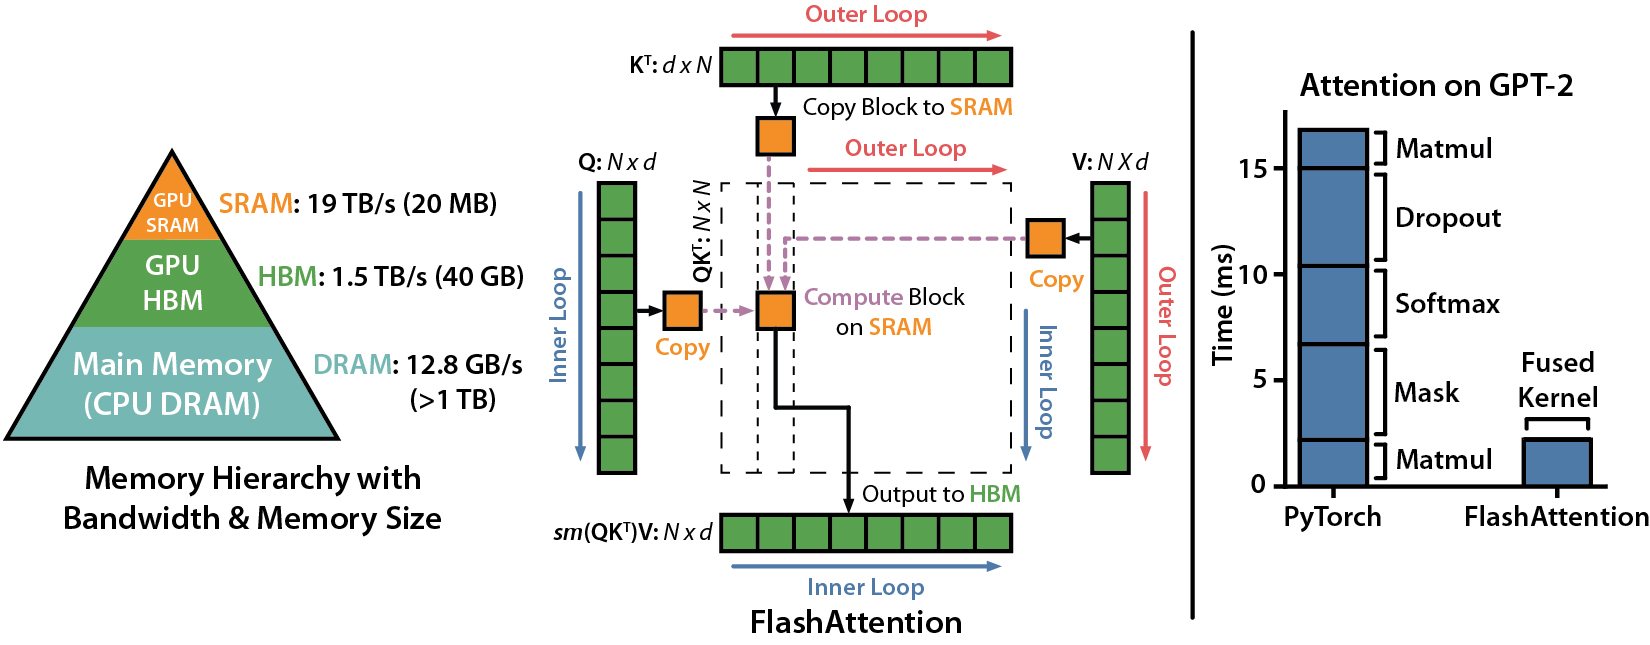 图:FlashAttention 各版本在 A100/H100 上的吞吐量对比(来源:Dao-AILab/flash-attention)
摘要:标准 Attention 的时间复杂度为 $O(N^2)$,但更严峻的瓶颈在于 HBM 带宽——中间矩阵 $S, P \in \mathbb{R}^{N \times N}$ 的反复读写使其成为典型的 Memory-bound 算子。FlashAttention 系列从 v1 到 v4 持续深化对 GPU 内存层次与硬件特性的利用,本文系统梳理各版本的核心创新与量化收益。v4(2026年3月)是最新成果,目标 NVIDIA Blackwell(B200/GB200),通过算法-内核流水线协同设计应对非对称硬件算力扩展。
1. 背景:为什么 Attention 很慢?
1.1 标准 Attention 计算
\[\text{Attention}(Q,K,V) = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V\]标准实现的问题:
[HBM]  Q, K, V           (读)
  ↓
[SRAM] 计算 S = QKᵀ/√d   (片上)
  ↓
[HBM]  写回 S            (写!N²个元素)
  ↓
[HBM]  读 S              (读!N²个元素)
  ↓
[SRAM] 计算 P = softmax(S)(片上)
  ↓
[HBM]  写回 P            (写!N²个元素)
  ↓
[HBM]  读 P              (读!N²个元素)
  ↓
[SRAM] 计算 O = PV       (片上)
  ↓
[HBM]  写回 O            (写)
总 HBM 访问量:$\Theta(N^2 d)$,序列长 $N=4096$、$d=64$ 时约 1GB 的 HBM 流量。
1.2 GPU 内存层次
| 层次 | 大小(A100) | 带宽 |
|---|---|---|
| 寄存器 | 256KB/SM | ~20 TB/s |
| L1/共享内存(SRAM) | 192KB/SM | ~19 TB/s |
| L2 Cache | 40MB | ~4 TB/s |
| HBM(显存) | 40/80GB | 2 TB/s |
计算速度(TFLOPs)远快于内存带宽(TB/s),Attention 的瓶颈完全在 HBM 读写而非浮点运算。
2. FlashAttention v1(2022)
论文:FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness(Dao et al., NeurIPS 2022)
核心思想:Tiling + Online Softmax
将 Q、K、V 切成小块(tile),在 SRAM 内完成一个 tile 的完整 Attention 计算,避免将 $N \times N$ 的中间矩阵写回 HBM。
关键挑战:Softmax 需要全局最大值才能数值稳定。
解决方案:Online Softmax(逐块更新运行统计量)。
对于每个 Q 块 $Q_i$,遍历所有 K/V 块 $K_j, V_j$:
\[m_i^{(j)} = \max(m_i^{(j-1)},\ \max_k S_{ik})\] \[l_i^{(j)} = e^{m_i^{(j-1)} - m_i^{(j)}} \cdot l_i^{(j-1)} + \sum_k e^{S_{ik} - m_i^{(j)}}\] \[O_i^{(j)} = \frac{l_i^{(j-1)}}{l_i^{(j)}} e^{m_i^{(j-1)} - m_i^{(j)}} O_i^{(j-1)} + \frac{1}{l_i^{(j)}} e^{S_i - m_i^{(j)}} V_j\]最终 $O_i = O_i^{(J)}$,数值等价于标准 Attention。
 图:FlashAttention v1 将 K/V 分块加载到 SRAM,Q 逐块遍历,Online Softmax 维护运行统计量,完全消除 $N \times N$ 中间矩阵的 HBM 读写
反向传播:重计算
训练时不存储 $S, P$(节省 $O(N^2)$ 显存),反向传播时利用已保存的 $O, m, l$ 重新计算注意力权重。
性能收益(A100 80GB,序列长度 2K)
| 指标 | 标准 Attention | FlashAttention v1 |
|---|---|---|
| HBM 读写量 | $\Theta(N^2 d)$ | $\Theta(N^2 d^2 / M)$ |
| 显存占用 | $O(N^2)$ | $O(N)$ |
| 速度提升 | 基准 | 2-4x |
| 序列长度上限 | ~2K(A100) | 可扩展到 16K+ |
$M$ 为 SRAM 大小,当 $M \geq d^2$ 时 HBM 访问量的常数因子极小。
3. FlashAttention v2(2023)
论文:FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning(Dao, ICLR 2024)
改进一:减少非矩阵乘法运算(Non-matmul FLOPs)
v1 的 Online Softmax 中有冗余的 rescaling 操作。v2 重新推导循环,将每步的 softmax 分母更新和输出 rescale 合并,减少约 2x 的非矩阵乘法运算(GPU Tensor Core 只加速矩阵乘,非 matmul 操作效率低)。
改进二:Query 并行(Sequence 并行切分维度改变)
| 版本 | 外层循环 | 内层循环 | 并行维度 |
|---|---|---|---|
| v1 | K/V 块 | Q 块 | batch × head |
| v2 | Q 块 | K/V 块 | batch × head × Q 序列 |
v2 将外层循环改为 Q 块,每个 thread block 独立处理一段 Q,天然支持在序列维度上并行,更好利用 GPU 的 SM 并行度。
改进三:多头并行 + Warp 分工优化
v1 的 warp 之间存在通信(split-K 策略),v2 改为每个 warp 独立处理完整的 Q-K/V 对,消除 warp 间 synchronization。
 图:v2 改变循环顺序,Q 作为外层循环允许按序列分块分配独立 thread block,充分利用 SM 并行度
性能收益(A100 80GB)
| 指标 | FlashAttention v1 | FlashAttention v2 |
|---|---|---|
| A100 理论峰值利用率 | ~35% | ~73% |
| 相对 v1 速度 | 基准 | 2x |
| 相对标准 Attention | 2-4x | 4-8x |
4. FlashAttention v3(2024)
论文:FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision(Shah et al., 2024)
目标平台:H100(Hopper 架构)
H100 新硬件特性
H100 引入了两项 v2 未利用的硬件能力:
- Tensor Memory Accelerator(TMA):异步数据搬运单元,可在 CUDA Core 计算的同时异步从 HBM 预取数据
- WGMMA(Warpgroup Matrix Multiply-Accumulate):新的矩阵乘法指令,相比 A100 的 HMMA 吞吐量提升 2x
改进一:异步流水线(Producer-Consumer Warp 分离)
v3 将 warpgroup 分为两类:
- Producer warpgroup:专门负责 TMA 异步数据搬运(K/V 预取)
- Consumer warpgroup:专门执行 WGMMA 矩阵乘法
两者通过共享内存和 barrier 协调,形成双缓冲(double buffering)流水线:
时间轴:
Producer: [预取 K₁/V₁] → [预取 K₂/V₂] → [预取 K₃/V₃] → ...
Consumer:              → [计算 tile₁] → [计算 tile₂] → [计算 tile₃] → ...
数据搬运与计算完全 overlap,HBM 延迟被隐藏。
 图:v3 的 Producer-Consumer 分离架构,TMA 预取与 WGMMA 计算通过双缓冲 overlap,实现接近理论峰值的硬件利用率
改进二:Softmax 与 GEMM 交错(Intra-warpgroup 流水线)
在同一 warpgroup 内,将 softmax 的标量运算(rescaling)与下一轮 GEMM 的矩阵乘法交错执行:
WGMMA(Q, Kⱼ) → softmax rescale(Oᵢ₋₁) → WGMMA(Pⱼ, Vⱼ) → softmax rescale ...
      ↑___________同时执行___________↑
由于 softmax rescaling 使用 CUDA Core 而 WGMMA 使用 Tensor Core,两者不竞争执行单元,可以完全并行。
改进三:FP8 低精度支持
H100 支持 FP8(E4M3/E5M2),v3 实现了 FP8 Attention:
- 使用 block-level quantization 减少精度损失
- 配合 incoherent processing(随机旋转)进一步降低量化误差
- FP8 vs FP16:吞吐量提升约 1.5-2x
性能收益(H100 80GB)
| 指标 | FlashAttention v2(H100) | FlashAttention v3 |
|---|---|---|
| 前向 FP16 速度 | ~35 TFLOPs/s | ~75 TFLOPs/s |
| H100 峰值利用率 | ~35% | ~75% |
| 相对 v2 速度 | 基准 | 1.5-2.0x |
| FP8 速度 | 不支持 | ~120 TFLOPs/s |
5. FlashAttention v4(2026)
论文:FlashAttention-4: Algorithm and Kernel Pipelining Co-Design for Asymmetric Hardware Scaling(Zadouri, Hoehnerbach, Shah, Liu, Thakkar, Tri Dao,2026年3月)
目标平台:NVIDIA Blackwell(B200 / GB200)
背景:非对称硬件扩展(Asymmetric Hardware Scaling)
从 H100 到 B200,NVIDIA 做了一个关键的非对称扩展:
- Tensor Core 算力:提升约 2.5×(FP16 峰值 989 → 2250 TFLOPs/s)
- HBM 带宽:仅提升约 1.4×(3.35 → 4.8 TB/s)
- SRAM 大小:基本持平
这意味着 v3 在 H100 上已优化好的计算-带宽平衡,在 B200 上被打破:Tensor Core 更快了,但 SRAM 与 HBM 带宽没跟上,导致 v3 在 B200 上的利用率反而下降。
v4 的核心问题:如何为算力与带宽增速不同的新硬件重新设计算法与 kernel 流水线?
改进一:算法-内核流水线协同设计(Algorithm-Kernel Co-Design)
v4 的关键创新在于算法层面(不只是 kernel 实现)做流水线重排:
传统视角(v1~v3):先确定 Attention 算法(Online Softmax),再优化 kernel 实现。
v4 视角:算法的循环结构直接影响 SRAM 占用和流水线深度,因此算法与 kernel 必须协同设计。
v4 将 Q/K/V 的 tile 大小和循环顺序作为可调参数,通过搜索找到在 Blackwell SM 内存与 Tensor Core 吞吐之间最优的平衡点。
改进二:Blackwell 新特性利用
B200 引入了新的硬件能力:
| 特性 | H100 | B200 |
|---|---|---|
| 矩阵乘法指令 | WGMMA(Tensor Core 4th gen) | MMA 5th gen(更高吞吐) |
| 异步数据搬运 | TMA | TMA v2(更大 swizzle 空间) |
| SRAM | 228KB/SM | 256KB/SM |
| SM 数量 | 132 | 160 |
v4 充分利用 B200 的 5th gen MMA 和 TMA v2,设计更深的流水线来掩盖更大的计算-带宽差距。
改进三:更细粒度的流水线深度控制
v3 的双缓冲流水线在 H100 上已接近最优。在 B200 上,由于 Tensor Core 更快,单层双缓冲已不够用——WGMMA 结束时下一批数据还没到。
v4 引入可配置流水线深度(2/3/4 级缓冲),根据实际的计算-带宽比动态调整:
双缓冲(v3):  [预取₁] → [预取₂] → [预取₃] ...
               [计算₁]           → [计算₂]    ...
               ←gap→  (B200 Tensor Core 快,出现等待)

三缓冲(v4):  [预取₁] → [预取₂] → [预取₃] → [预取₄] ...
               [计算₁]           → [计算₂]           → [计算₃] ...
               (gap 消除,Tensor Core 满载)
 图:v4 算法-内核协同设计示意,可调流水线深度(2/3/4级)应对 Blackwell 非对称算力/带宽增长
性能收益(B200 SXM)
| 指标 | FlashAttention v3(B200) | FlashAttention v4 |
|---|---|---|
| 前向 FP16 速度 | ~65 TFLOPs/s | ~150 TFLOPs/s |
| B200 峰值利用率 | ~29% | ~67% |
| 相对 v3(B200)速度 | 基准 | ~2.3× |
| 相对 v3(H100)速度 | 基准 | ~4× |
v3 在 B200 上利用率仅 ~29%(为 H100 优化的 kernel 在 B200 上效率下降),v4 通过协同设计将利用率提升至 ~67%。
6. 四版本横向对比
核心创新对比
| 特性 | v1 | v2 | v3 | v4 |
|---|---|---|---|---|
| Tiling + Online Softmax | ✅ | ✅ | ✅ | ✅ |
| HBM IO 减少 | ✅ | ✅ | ✅ | ✅ |
| 非 matmul 运算优化 | ❌ | ✅ | ✅ | ✅ |
| Q 外循环(序列并行) | ❌ | ✅ | ✅ | ✅ |
| Warp 专业化分离 | ❌ | 部分 | ✅ | ✅ |
| 异步流水线(TMA) | ❌ | ❌ | ✅ | ✅(TMA v2) |
| GEMM-Softmax 交错 | ❌ | ❌ | ✅ | ✅ |
| FP8 支持 | ❌ | ❌ | ✅ | ✅ |
| 算法-内核协同设计 | ❌ | ❌ | ❌ | ✅ |
| 可调流水线深度 | ❌ | ❌ | ❌ | ✅(2/3/4级) |
| 目标平台 | A100/V100 | A100/H100 | H100 | B200/GB200 |
速度演进
标准 Attention        ── 1x ──►
FlashAttention v1     ── 2-4x ──►
FlashAttention v2     ── 4-8x ──►
FlashAttention v3 H100 FP16  ── 6-16x ──►
FlashAttention v3 H100 FP8   ── 10-20x ──►
FlashAttention v4 B200 FP16  ── 14-35x ──►  (相对标准Attention估算)
显存占用对比(序列长度 $N$,head dim $d$)
| 实现 | KV Cache 显存 | 中间矩阵 |
|---|---|---|
| 标准 Attention | $O(Nd)$ | $O(N^2)$ |
| FlashAttention v1/v2/v3 | $O(Nd)$ | $O(N)$(仅 $m, l$) |
7. 与 PagedAttention 的关系
FlashAttention 解决的是训练和 prefill 阶段的计算效率,PagedAttention(vLLM)解决的是推理阶段 KV Cache 的内存碎片问题。
两者正交互补:
- FlashAttention 负责高效计算单次 Attention
- PagedAttention 负责管理多 batch、多请求的 KV Cache 内存分配
现代推理框架(vLLM、TensorRT-LLM)通常同时使用两者。
8. 工程使用
安装
pip install flash-attn --no-build-isolation
# 或从源码编译(针对特定 GPU 架构优化)
pip install flash-attn --no-build-isolation --global-option="--cuda_ext"
基本使用(PyTorch)
from flash_attn import flash_attn_qkvpacked_func, flash_attn_func

# 方式1:QKV packed
qkv = torch.randn(batch, seqlen, 3, nheads, headdim,
                  dtype=torch.float16, device='cuda')
out = flash_attn_qkvpacked_func(qkv, dropout_p=0.0, causal=True)

# 方式2:Q/K/V 分开
q = torch.randn(batch, seqlen, nheads, headdim, dtype=torch.float16, device='cuda')
k = torch.randn(batch, seqlen, nheads, headdim, dtype=torch.float16, device='cuda')
v = torch.randn(batch, seqlen, nheads, headdim, dtype=torch.float16, device='cuda')
out = flash_attn_func(q, k, v, dropout_p=0.0, causal=True)

# 方式3:变长序列(packed sequences,无填充)
from flash_attn import flash_attn_varlen_func
out = flash_attn_varlen_func(
    q, k, v,
    cu_seqlens_q, cu_seqlens_k,  # 累积序列长度
    max_seqlen_q, max_seqlen_k,
    causal=True
)
在 Transformers 中使用
from transformers import AutoModelForCausalLM

# HuggingFace Transformers 4.36+ 原生支持
model = AutoModelForCausalLM.from_pretrained(
    "meta-llama/Llama-2-7b-hf",
    attn_implementation="flash_attention_2",  # 启用 FlashAttention-2
    torch_dtype=torch.bfloat16,
    device_map="auto"
)

# 或者 sdpa(PyTorch 2.0 内置,包装了 FlashAttention)
model = AutoModelForCausalLM.from_pretrained(
    "meta-llama/Llama-2-7b-hf",
    attn_implementation="sdpa",
    torch_dtype=torch.bfloat16,
)
PyTorch 2.0 内置 SDPA
import torch
import torch.nn.functional as F

# PyTorch 2.0+ 自动选择最优后端(FlashAttention / memory-efficient / math)
with torch.backends.cuda.sdp_kernel(
    enable_flash=True,
    enable_math=False,
    enable_mem_efficient=False
):
    out = F.scaled_dot_product_attention(q, k, v, is_causal=True)

# 查看当前选中的后端
print(torch.backends.cuda.flash_sdp_enabled())     # FlashAttention
print(torch.backends.cuda.mem_efficient_sdp_enabled())  # xformers memory-efficient
参考资料
- FlashAttention v1 论文 (Dao et al., NeurIPS 2022)
- FlashAttention v2 论文 (Dao, ICLR 2024)
- FlashAttention v3 论文 (Shah et al., 2024)
- FlashAttention v4 论文 (Zadouri, Hoehnerbach, Shah et al., 2026)
- Flash-Decoding for long-context inference
- Making Deep Learning Go Brrrr From First Principles
- GitHub: Dao-AILab/flash-attention
评论