
DeepEP:DeepSeek 开源的 MoE 专家并行通信库深度解析
项目:DeepEP: an efficient expert-parallel communication library
作者:Chenggang Zhao, Shangyan Zhou, Liyue Zhang, Chengqi Deng 等(DeepSeek)
开源时间:2025 年 2 月(DeepSeek 开源周第二日)
笔记整理:chengenbao · 2026-03
一、DeepEP 解决的核心问题
MoE(Mixture of Experts)架构通过稀疏激活大幅降低训练和推理的计算量,但其分布式通信是最关键的性能瓶颈。具体来说:
- All-to-All 通信开销巨大:MoE 的专家并行(EP)需要在 GPU 之间进行 All-to-All 通信——每个 GPU 将 token 分发(dispatch)到目标专家所在的 GPU,计算完成后再合并(combine)回来。这一操作随 GPU 数量增长通信量急剧膨胀。
- 训练与推理需求矛盾:训练阶段追求高吞吐(大 batch),推理解码阶段追求低延迟(小 batch),两者对通信内核的设计需求完全不同。
- 异构带宽不匹配:节点内 NVLink(~160 GB/s)与节点间 RDMA(~50 GB/s)带宽差距 3 倍以上,naive 实现无法充分利用硬件。
- 通信占用计算资源:传统通信实现需要占用 GPU 的 SM(流多处理器),挤占计算资源。
DeepEP 是全球首个专为 MoE 专家并行设计的开源通信库,针对以上问题提供了系统性的解决方案。
二、整体架构:双内核设计
DeepEP 的核心设计思想是针对不同场景提供不同的通信内核,而非用一套方案适配所有需求。
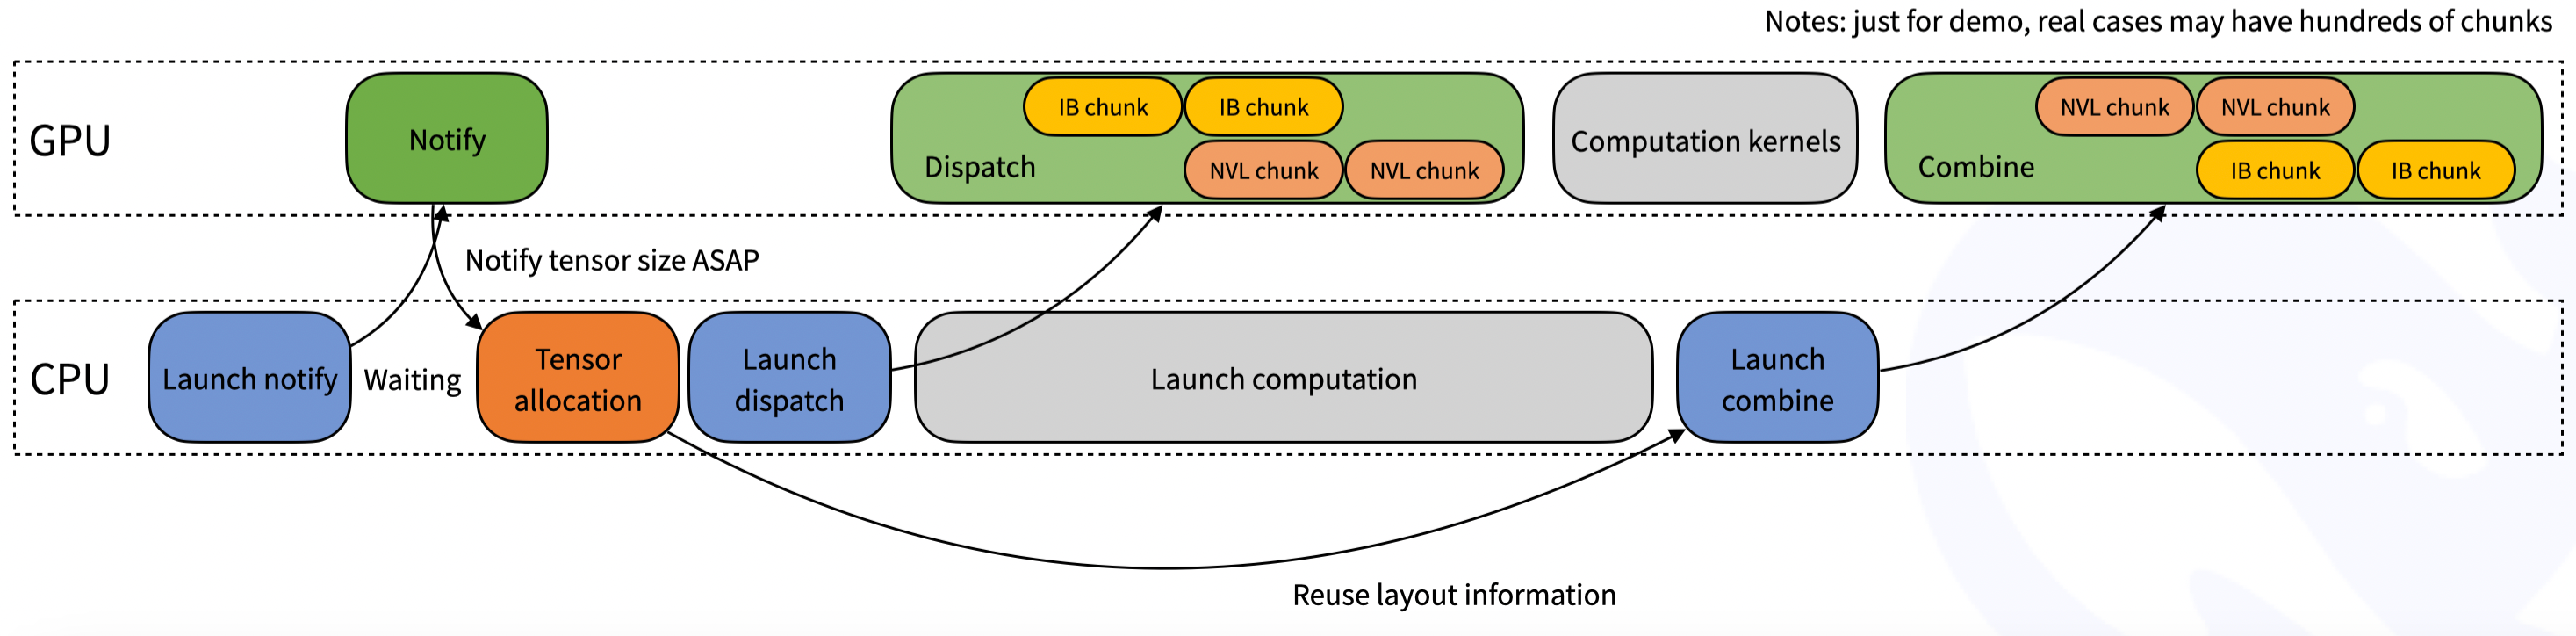 图:常规内核(Normal Kernel)架构——用于训练和推理预填充阶段,支持 NVLink + RDMA 带宽转发。
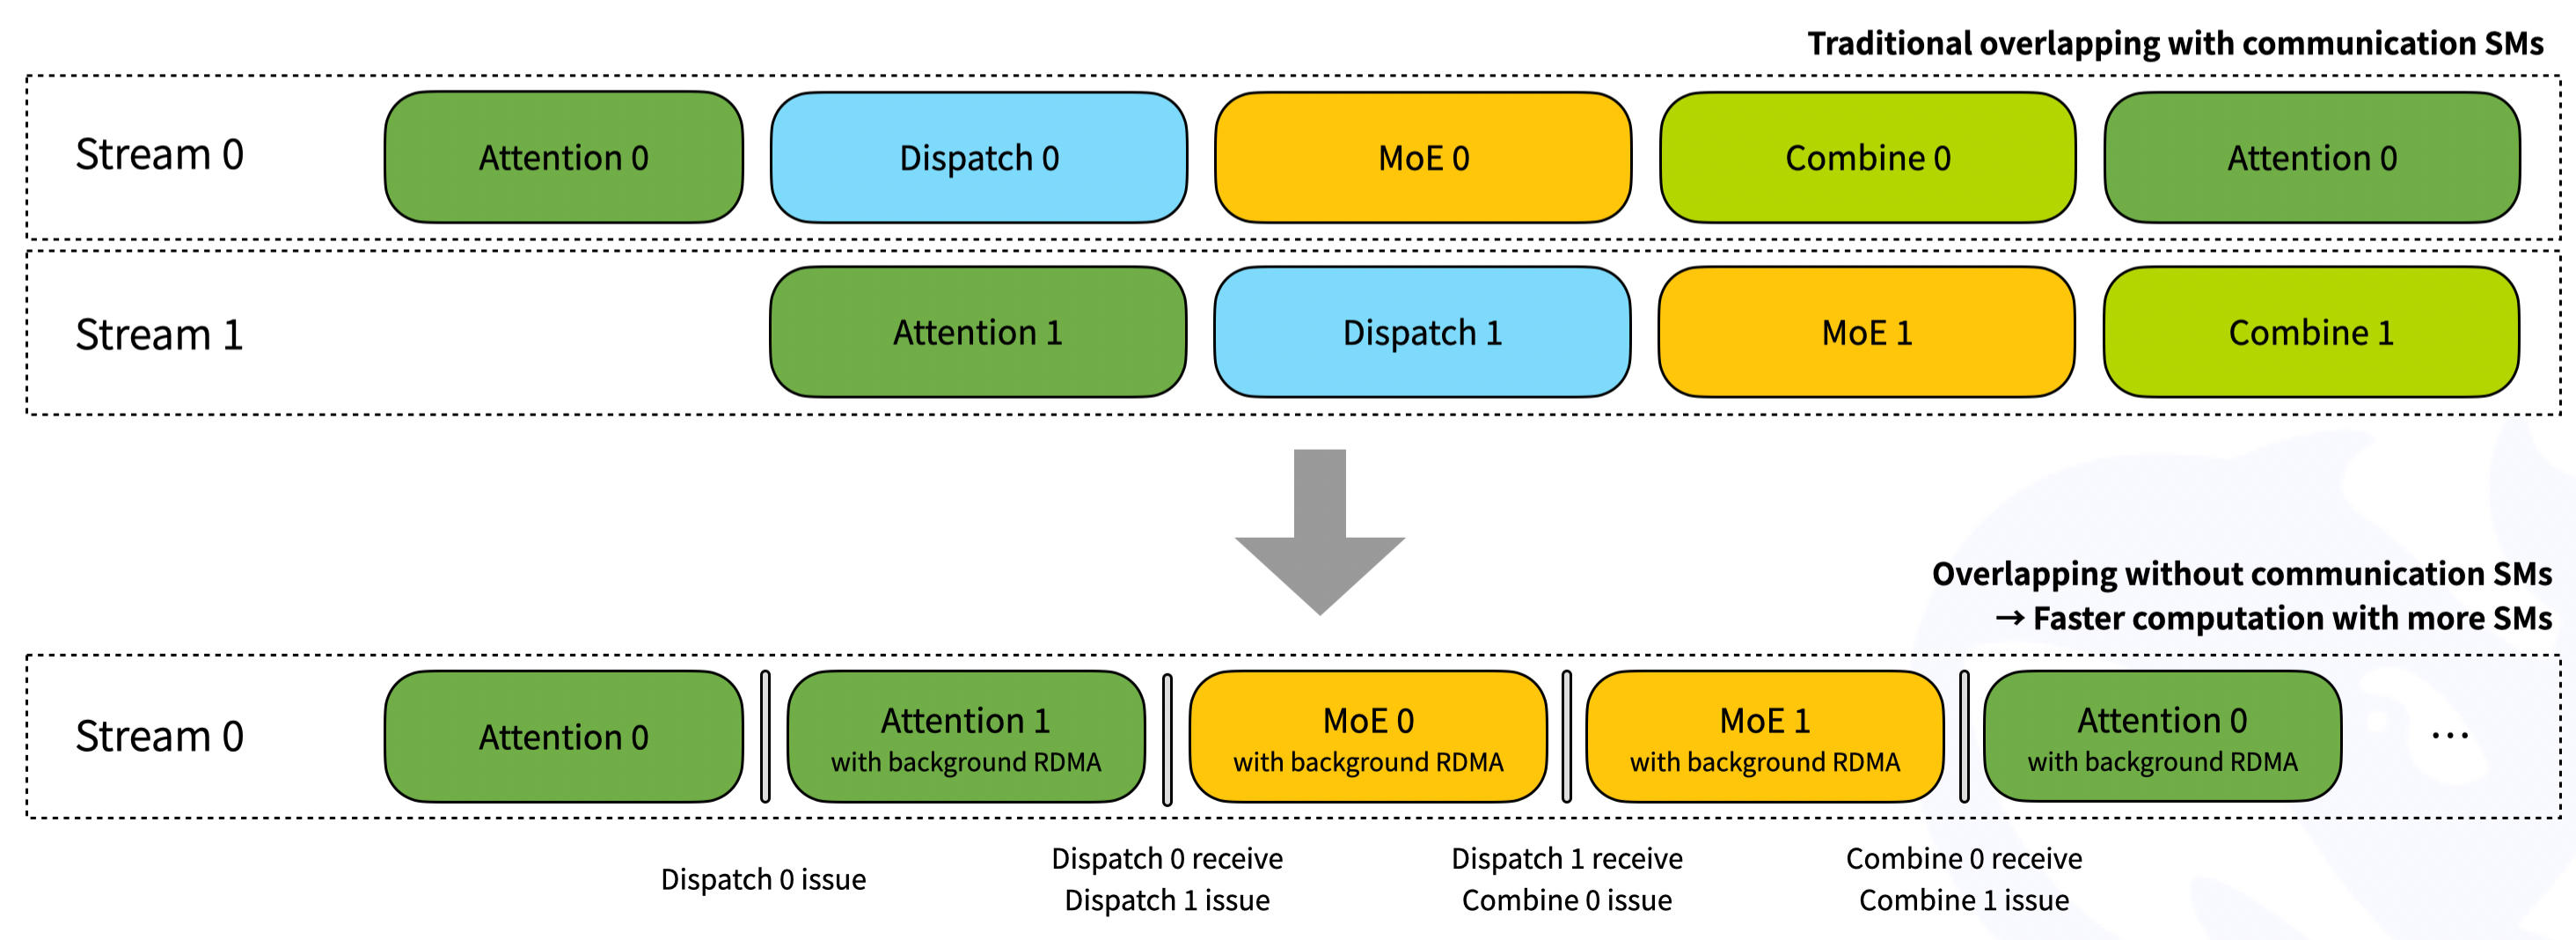 图:低延迟内核(Low-Latency Kernel)架构——用于推理解码阶段,采用纯 RDMA 通信以最小化延迟。
2.1 高吞吐内核(Normal Kernel)
适用场景:模型训练 + 推理预填充(Prefill),batch 较大(如 4096 tokens/batch)。
核心技术:
- NVLink-RDMA 非对称带宽转发:节点内 GPU 通过 NVLink 高速交换数据,再由特定 GPU 作为”代理”通过 RDMA 转发到远端节点。这种分层设计充分利用了 NVLink 的高带宽。
- 流水线调度:在非对称带宽场景下(NVLink → RDMA 存在 3 倍带宽差),通过流水线重叠收发操作,保持 90% 以上的带宽利用率。
- SM 数量控制:通过
Buffer.set_num_sms()API 精确控制通信使用的 SM 数量,为计算任务预留充足的 SM 资源。 - 与 DeepSeek-V3 对齐:支持 DeepSeek-V3 论文中提出的组受限门控(Group-Restricted Gating)算法。
2.2 低延迟内核(Low-Latency Kernel)
适用场景:推理解码(Decoding),batch 较小(如 128 tokens/batch),对延迟极度敏感。
核心技术:
- 纯 RDMA 通信:绕过 NVLink 的分层转发,直接使用 RDMA 进行 GPU 间通信,避免多跳引入的额外延迟。
- CUDA Graph 兼容:低延迟内核支持 CUDA Graph 捕获和回放,减少 kernel launch 开销。
- Hook 机制实现零 SM 占用:引入了基于 Hook 的通信-计算重叠方法——通信操作通过 RDMA 硬件异步执行,不占用任何 SM 资源,GPU 的全部 SM 都可用于计算。
- 双批次重叠(Double-Batch Overlap):通过
return_recv_hook=True延迟接收操作,上一批次的通信可以与当前批次的计算完全重叠。
三、通信原语:Dispatch 与 Combine
MoE 的专家并行通信可以抽象为两个核心操作:
3.1 Dispatch(分发)
将每个 GPU 上的 token 根据路由结果(topk_idx)发送到目标专家所在的 GPU。
流程:
- 计算布局(
get_dispatch_layout):根据topk_idx统计每个 GPU/专家需要接收多少 token - 执行分发(
dispatch):通过 All-to-All 通信将 token 数据、路由索引和权重发送到目标 GPU - 输出:目标 GPU 收到属于自己专家的所有 token
3.2 Combine(合并)
专家计算完成后,将结果按原路发回各 token 所属的原始 GPU。
流程:
- 根据 dispatch 阶段保存的
handle(记录了路由映射关系) - 执行反向 All-to-All 通信
- 按
topk_weights加权合并多个专家的输出
3.3 反向传播的对称性
一个巧妙的设计——dispatch 的反向传播就是 combine,combine 的反向传播就是 dispatch。这意味着同一套通信内核同时服务前向和反向传播,代码复用度极高。
四、FP8 原生支持
DeepEP 原生支持 FP8 数据格式,这对 MoE 通信的意义尤为重大:
- 带宽减半:FP8 相比 BF16 数据量减少 50%,在带宽受限的 RDMA 场景下效果显著
- DeepSeek-V3/R1 生产配置:FP8 dispatch + BF16 combine(分发时压缩,合并时保持精度)
- 显存节省约 40%:通信缓冲区占用大幅下降
- 动态精度切换:调度器支持根据任务需求动态切换精度模式
五、Hook 机制:零 SM 占用的通信-计算重叠
Hook 机制是 DeepEP 在低延迟模式下的核心创新之一。
5.1 传统方案的问题
传统的通信-计算重叠需要占用部分 SM 来执行通信 kernel,导致:
- SM 资源竞争,计算和通信互相干扰
- 调度复杂度高,难以最优分配 SM
5.2 Hook 的工作原理
DeepEP 的 Hook 机制利用 RDMA 硬件的异步特性:
- 发送阶段:GPU 将数据写入 RDMA 缓冲区后,由网卡硬件异步完成传输,GPU 立即返回执行计算
- 接收阶段:通过
return_recv_hook=True,dispatch函数立即返回但不立即接收数据 - 延迟触发:调用
hook()时才实际执行接收操作,此时数据已在 RDMA 缓冲区就绪
# 低延迟 dispatch 示例
recv_hidden_states, recv_expert_count, handle, event, hook = \
    _buffer.low_latency_dispatch(hidden_states, topk_idx,
                                 num_max_dispatch_tokens_per_rank, num_experts,
                                 async_finish=False, return_recv_hook=True)

# GPU 继续执行其他计算...
# 需要数据时才调用 hook
hook()  # 此时数据已通过 RDMA 传输完成
5.3 双批次重叠
在推理解码场景下,Hook 机制支持双批次重叠:
- 批次 N 的通信与批次 N-1 的专家计算并行执行
- 全程不占用 SM 资源
- 实现接近理论极限的硬件利用率
六、性能实测
所有测试在 H800 GPU 上进行,节点内 NVLink 峰值带宽 ~160 GB/s,每张 GPU 连接 CX7 InfiniBand 400 Gb/s RDMA 网卡(~50 GB/s 峰值带宽)。
6.1 高吞吐内核性能
配置:DeepSeek-V3/R1 预训练设置(4096 tokens/batch,7168 hidden,top-4 groups,top-8 experts,FP8 dispatch + BF16 combine)。
| 类型 | EP 数 | Dispatch 瓶颈带宽 | Combine 瓶颈带宽 |
|---|---|---|---|
| 节点内(NVLink) | 8 | 153 GB/s | 158 GB/s |
| 节点间(RDMA) | 16 | 43 GB/s | 43 GB/s |
| 节点间(RDMA) | 32 | 58 GB/s | 57 GB/s |
| 节点间(RDMA) | 64 | 51 GB/s | 50 GB/s |
关键发现:
- 节点内带宽利用率达到 95%+(153/160 GB/s)
- 节点间 32 EP 时带宽竟超过 16 EP,原因是更多 GPU 参与时单卡发送量降低,RDMA 拥塞减少
- 整体带宽利用率维持在 86%~99%
6.2 低延迟内核性能
配置:DeepSeek-V3/R1 生产环境设置(128 tokens/batch,7168 hidden,top-8 experts,FP8 dispatch + BF16 combine)。
| EP 数 | Dispatch 延迟 | Dispatch RDMA 带宽 | Combine 延迟 | Combine RDMA 带宽 |
|---|---|---|---|---|
| 8 | 77 μs | 98 GB/s | 114 μs | 127 GB/s |
| 16 | 118 μs | 63 GB/s | 195 μs | 74 GB/s |
| 32 | 155 μs | 48 GB/s | 273 μs | 53 GB/s |
| 64 | 173 μs | 43 GB/s | 314 μs | 46 GB/s |
| 128 | 192 μs | 39 GB/s | 369 μs | 39 GB/s |
| 256 | 194 μs | 39 GB/s | 360 μs | 40 GB/s |
关键发现:
- 8 EP 时 dispatch 延迟仅 77 μs(微秒级),combine 延迟 114 μs
- 从 128 EP 到 256 EP,延迟几乎不增长,说明通信复杂度在大规模下趋于平稳
- 小 batch 下 RDMA 带宽利用率反而更高(8 EP 时达到 127 GB/s,远超理论峰值 50 GB/s,因为多 QP 并行)
七、网络配置最佳实践
DeepEP 在 InfiniBand 网络上经过充分测试,同时理论兼容 RoCE(RDMA over Converged Ethernet)。
7.1 流量隔离
InfiniBand 通过虚拟通道(Virtual Lane)支持流量隔离。DeepEP 建议将三类流量分离到不同通道:
| 流量类型 | 推荐虚拟通道 | 配置方式 |
|---|---|---|
| 高吞吐内核通信 | VL 0 | NVSHMEM_IB_SL=0 |
| 低延迟内核通信 | VL 1 | NVSHMEM_IB_SL=1 |
| 其他工作负载 | VL 2 | 默认 |
7.2 自适应路由
- 网络负载重:启用自适应路由(Adaptive Routing),交换机自动跨多路径均匀分布流量,消除路由冲突
- 网络负载轻:使用静态路由,避免自适应路由引入的额外延迟
7.3 拥塞控制
DeepEP 在生产环境中禁用了拥塞控制,因为实测未观察到明显拥塞。这一选择减少了协议开销,进一步降低延迟。
八、高级技术细节
8.1 未定义行为 PTX 的极致优化
为追求极致性能,DeepEP 使用了一种未定义行为的 PTX 指令:
ld.global.nc.L1::no_allocate.L2::256B
.nc(non-coherent)修饰符原本用于只读数据- DeepEP 用它来读取 volatile 数据,这在标准 PTX 规范中是未定义行为
- 但在 Hopper 架构上,配合
.L1::no_allocate,实测可保证正确性且性能显著提升 - 提供
DISABLE_AGGRESSIVE_PTX_INSTRS=1环境变量用于在其他平台禁用
8.2 NVSHMEM 依赖
DeepEP 基于 NVIDIA 的 NVSHMEM 库实现 GPU 间直接内存访问。NVSHMEM 提供了:
- GPU 发起的远程内存读写(put/get)
- GPU 间的原子操作和同步原语
- 与 RDMA 网卡的直接交互
8.3 Buffer 管理
DeepEP 使用队列管理通信缓冲区以节省内存,但官方建议在自行实现时可以改用固定大小缓冲区(分配到最大容量),以简化设计并获得更好性能。
九、关键设计思想总结
-
场景分治:高吞吐内核和低延迟内核的双内核设计,拒绝”一刀切”,针对训练和推理解码各自的特点分别优化。
-
硬件感知:从 NVLink 与 RDMA 的非对称带宽特性出发设计通信拓扑,而非让软件去适应统一抽象。
-
零 SM 占用通信:Hook 机制将通信完全卸载到 RDMA 硬件,GPU 的全部计算资源用于模型运算。
-
FP8 通信压缩:在通信密集的 dispatch 阶段使用 FP8,在精度敏感的 combine 阶段使用 BF16,兼顾效率与精度。
-
极致性能优先:不惜使用未定义行为 PTX 指令来压榨最后一点性能,同时提供安全回退选项。
十、与相关工作的对比
| 维度 | DeepEP | DeepSpeed-MoE | NCCL All-to-All |
|---|---|---|---|
| 定位 | MoE 专用通信库 | 端到端 MoE 训练推理框架 | 通用集合通信 |
| 内核模式 | 双模式(高吞吐 + 低延迟) | 分层 All-to-All | 单一模式 |
| SM 资源控制 | 精确控制 + Hook 零占用 | 无 | 无 |
| FP8 支持 | 原生支持 | 无 | 无 |
| NVLink-RDMA 协同 | 非对称带宽转发优化 | 分层通信 | 自动选择 |
| 开源协议 | MIT | Apache 2.0 | BSD |
| 与 DeepSeek-V3 对齐 | 完全对齐 | 无关 | 无关 |
十一、社区生态与演进
DeepEP 自 2025 年 2 月开源以来,已发展出丰富的社区生态:
- 腾讯优化:腾讯网络平台部门贡献的 Zero-copy 分支,消除 PyTorch 张量和通信缓冲区之间的拷贝,性能提升 30%
- 蚂蚁集团优化:Normal-SMFree、LL-SBO、LL-Layered 等优化系列
- AMD 支持:Mori-EP 分支支持 ROCm/AMD GPU
- 异构 GPU 支持:uccl-ep 支持跨 Nvidia/AMD GPU 和 EFA/Broadcom/CX7 网卡运行
- 诊断工具:DeepXTrace 用于精确定位慢节点
截至 2026 年 3 月,GitHub 已获 9k+ Stars、1.1k+ Forks、240+ Commits。
参考
- GitHub 仓库:deepseek-ai/DeepEP
- DeepSeek-V3 论文:arXiv:2412.19437
- DeepSpeed-MoE 论文:arXiv:2201.05596
评论